今天这期周刊,我们从看医生前的一件小事说起:如果只有几分钟,怎么把病情讲清楚,把最想问的问题问出来?
Google 的研究让 AI 帮患者整理病情、准备问题,布朗大学医学院和布朗大学医疗体系的团队则让模型从卒中手术报告里提取数据。
用药之后呢?
美国 Mass General Brigham 医疗体系和哈佛医学院的研究人员,试着用 AI 从病历里找出免疫治疗的副作用。
清华和港大等团队还发现,推理模型更常答对主要诊断,也更容易列出不成立的诊断。
预印本|10 月 30 日|Google Research 与 Google DeepMind
Google Research 和 Google DeepMind 的研究人员让 AI 在就诊前询问患者的情况,帮他们排出最想问医生的问题,再整理成摘要。
两组都用 Gemini 2.5 Flash。
一组的助手会按步骤追问,另一组的聊天机器人只收到简单的提示。
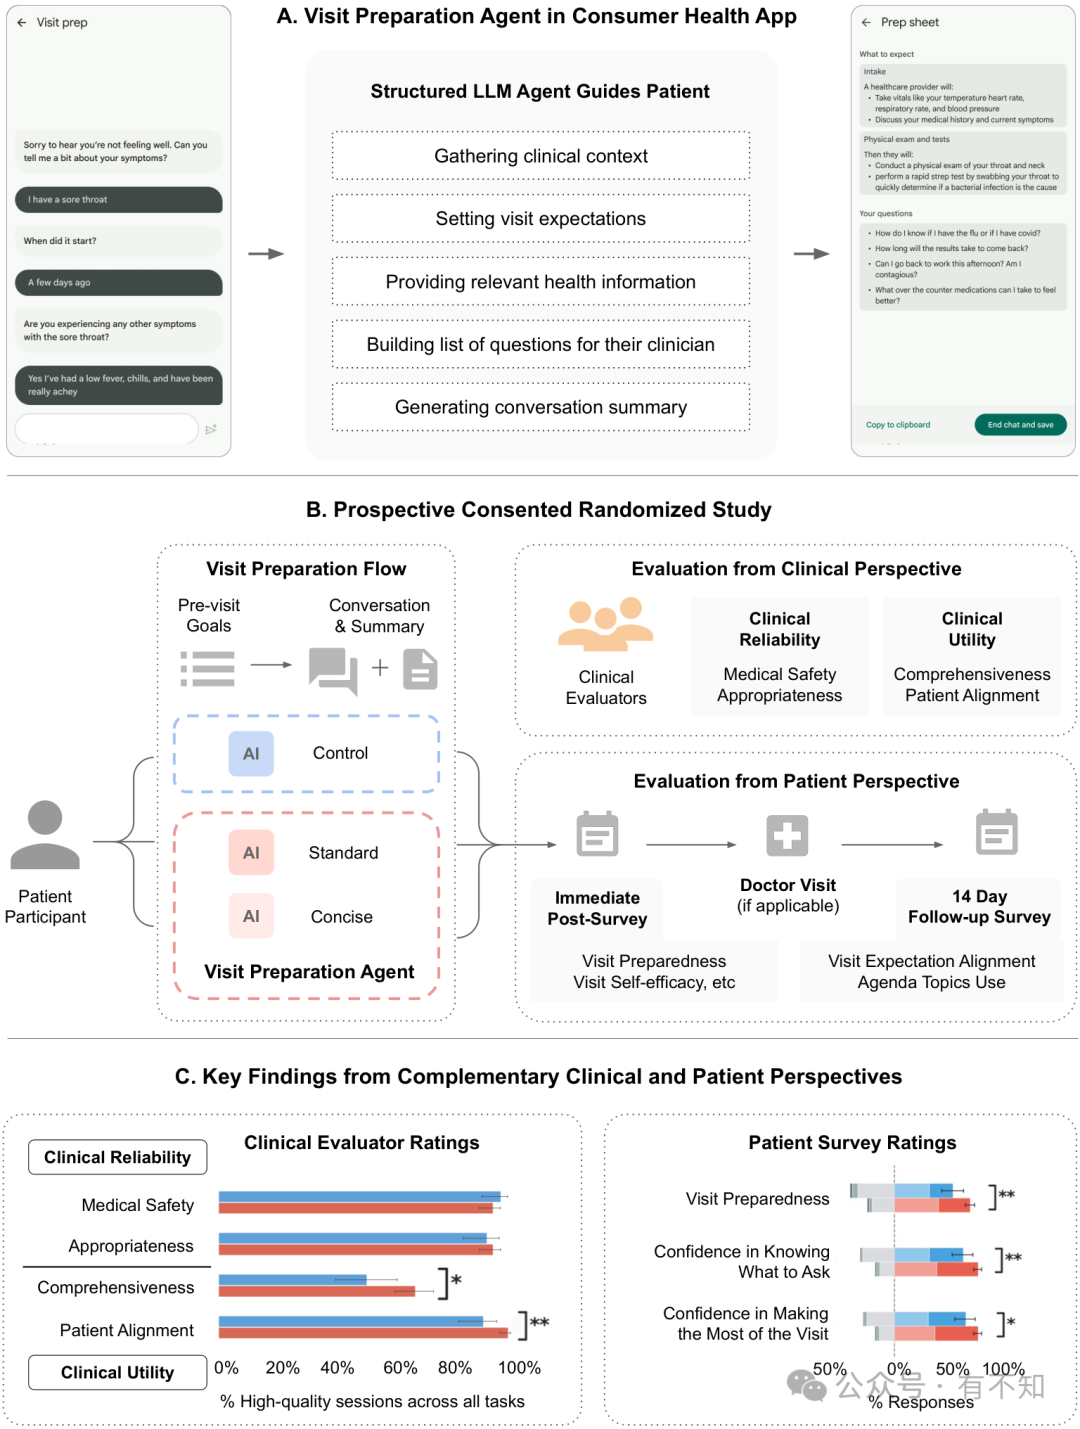
图 1:论文展示了从了解病情到整理就诊问题的对话流程。
图源:arXiv 预印本 Figure 1。
研究在 Google Health 应用内随机分组,802 名美国成年人共进行了 866 次健康对话。
医生评估了 272 次走完整个流程的对话,评估时不知道对话来自哪一组。
按步骤引导的一组,67.2% 的对话被评为就诊准备充分,另一组为 50.6%。
研究主要衡量就诊准备质量和用户感受,仍需追踪实际就诊沟通与健康结果。
预印本|10 月 28 日(北京时间)|布朗大学医学院与布朗大学医疗体系
美国布朗大学沃伦·阿尔珀特医学院和布朗大学医疗体系(Brown University Health)的研究人员,收集了该医疗体系下属三家医院的 2,416 份急性卒中介入报告。
他们测试了 22 个开源语言模型,看模型能否从报告中找出八项信息。
前四项包括血管堵塞的位置、卒中严重程度评分(NIHSS)、是否接受静脉溶栓,以及术后血流恢复的分级(TICI),另外四项记录的是是否置入颈动脉支架、是否做了颈动脉血管成形术、是否置入颅内支架,以及是否做了颅内血管成形术。
在纳入比较的记录上,Meta 开发的 Llama 3.3 70B 在 22 个模型中总体提取准确率最高,为 94.8%。
研究人员主要用非医学专家标出的答案来给模型打分。
遇到答案有分歧时,他们请医生和医学生复查了其中一部分。
正式论文|10 月 29 日|Nature Cancer
来自美国波士顿 Mass General Brigham 医疗体系和哈佛医学院的 Jack Gallifant,与达纳-法伯癌症研究所等机构的合作者一起,让大语言模型从临床笔记中找出六类免疫相关不良事件,并记录副作用何时出现、有多严重,以及病历里把它归因于什么。
研究人员用已有病历做测试,发现 AI 比较擅长找出病历里记录的副作用,但判断副作用有多严重时,表现就差一些。
用兼顾漏报和误报的 F1 分数衡量,识别当前副作用的六类平均得分为 0.92,判断严重程度得 0.66 分,满分都是 1 分。
团队还用之后产生的病历测试系统,让它在后台运行,结果不进入诊疗流程。
他们也让工作人员分别在有 AI 和没有 AI 的情况下审核病历,以比较两种做法的表现。
研究衡量的是病历审核效果,患者用药后的结果仍需另行研究。
预印本|10 月 30 日|InstaDeep
InstaDeep 的研究人员把临床试验登记里的十项资料整理成文字,再用两种医学语言模型预测各阶段的试验能否成功。
这套评测的数据包含 12,477 项试验。
按成功可能性给试验排序时,四种模型方案的得分都高于已有方法 HINT 的公开成绩。
但如果必须给每项试验一个“成功”或“失败”的判断,结果就不同了。
按兼顾漏判和误判的评分,四种方案都没有明显胜过“把所有试验都猜成会成功”这个简单做法。
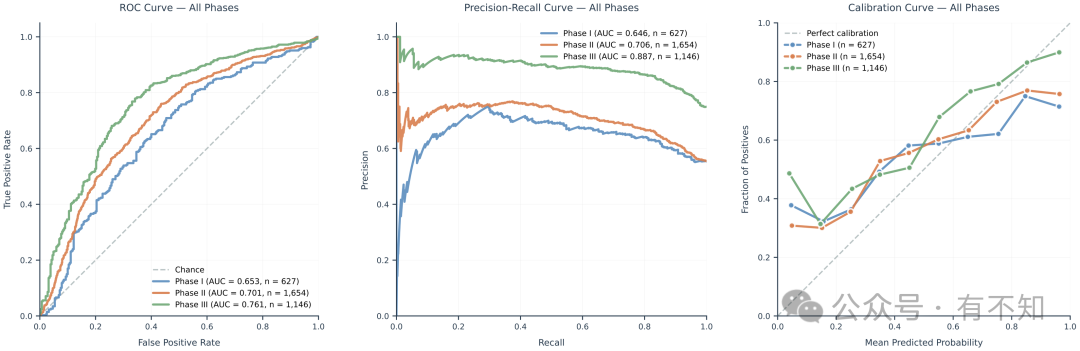
图 3:论文展示 BioMistral 微调后的预测曲线。
图源:arXiv 预印本 Figure 7。
研究还比较了两种训练办法。
一种是继续调整语言模型,另一种是保留原模型,只训练一个小工具来判断成败。
两种办法的分数大多接近,研究还没有检验这些差距是否可能由偶然波动造成。
免责声明:
智慧医疗网转载其他网站内容,出于传递更多信息而非盈利之目的,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任!
凡来源注明智慧医疗网的内容为智慧医疗网原创,转载需获授权。