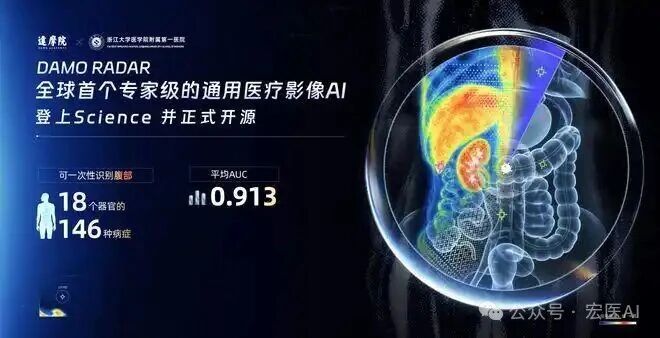
达摩院 DAMO RADAR 开源,腹部 CT 一次覆盖 146 种病灶、18 个器官。本文写给医院技术团队:它到底是什么、医院能用它做什么、还差什么,以及怎么一步步补齐到可诊断输出。
9 月 18 日,阿里达摩院的腹部 CT 影像 AI 模型 DAMO RADAR 正式开源,论文同期刊在《科学》上。模型一次能覆盖 146 种病灶、18 个器官,官方公布的平均准确率(AUC)是 0.913。我们已经在本地部署,开始接入系统做验证。这篇文章是这几天时间梳理出来的东西:它到底是什么、医院能用它做什么、还差什么,以及怎么一步步补齐。
这次开源的代码,包括推理和训练,都在 GitHub 上,Apache 2.0 协议,可以随便看、随便改,商用也没问题。模型权重放在 HuggingFace 上,采用 CC BY-NC-SA 4.0,非商用协议。
注意两个细节:推理单元是"器官",146 个标签不是 146 次独立推断,而是 18 个器官向量对 146 个文本向量的查表;滑窗是逐窗跑的,整例推理是分钟级,不是秒级。
一是分割反向控制特征聚合,代价是分割成了单点故障。器官 mask 会被下采样成布尔掩码,标记"哪些 token 属于这个器官",注意力范围被掩码屏蔽,肝和肾用完全不同的参数提问。这保证了特征聚焦在器官内部、抗背景干扰,但代价也很直接:器官没分割出来,这个器官下面的标签就全部失效。
二是文本向量离线固化,换来的是换标签免重训。146 个标签各对应一对"有/无该病"的文本向量(2×256 维),推理时就是一行矩阵乘法加 softmax。想加标签、换标签,不用动模型,重新算一遍文本向量文件就行。这是医院做私有标签扩充成本最低的入口,也意味着判别逻辑可以热插拔。
三是训练范式是 ALBEF/BLIP 一系,数据量不小。代码里的动量队列、温度系数这些配置指向动量编码器加负样本队列的对比学习范式;官方口径是 40 万例增强腹部 CT、1500 万图文对,直接从临床报告学,不需要人工标注,训练规模约 24 块 A100/H20。代码里还留了报告生成模块的接口,但这次没有放出生成权重。
能上线的形态:后台预读、防漏提醒、分诊排序、报告预填的候选。不能做的:独立出诊断意见、收费、单独出筛查报告。
拿 50 到 100 例历史增强 CT 和已签报告,逐病灶算灵敏度、特异度和混淆矩阵,跟官方 0.913 对齐。有两个坑要提前知道:官方数据来自它自己的数据集(近 4 万例真实检查的口径),不代表本院机型、层厚、增强方案和病种分布;所以验证别只看总体 AUC,按层厚、机型、增强相、病种分布做分层,才能知道模型在本院的真实画像:哪些病种可靠、哪些是短板。
模型只给概率,没有官方阈值。146 个标签各设各的阈值,按病灶恶性权重分档:良性高发的(囊肿、结石类)阈值放高,压假阳;恶性权重高的(胰腺癌、胆管癌这类)阈值放低,保敏感。0.6 的肝囊肿和 0.6 的胰腺癌,临床含义完全不同,不能用一个标准。这份阈值表本身就是你们自己的临床资产。
可解释性补全。用 organ_token_flags 把器官向量反投影回原图,得到响应区域,让每个概率"有图可依"。这是免重训的,直接决定医生信不信你。
工作流集成。接 PACS/RIS,DICOM 序列到位后异步预跑,做成院内私有化 Agent 平台的影像预读技能。分钟级推理决定它适合"报告前的异步预读",不适合"看片时的实时交互"。
输出治理。146 个标签绝大多数是 0.01 量级,直接输出就是噪音。按阈值过滤后只保留 Top-K,折叠同类项,按器官分组展示,医生扫一眼就能用。
验证类,门槛最低。在本院数据上重测,形成第三方独立验证。这是影像 AI 论文最常见也最被认可的增量。可以做得更细:按层厚、机型、增强相做亚组分析,把"模型在哪些条件下失效"讲清楚;对失败样本做系统性归因,比如分割未检出、补推未通过、高假阳、阈值敏感区,形成一份失败模式清单,本身就是一篇方法学文章。
方法类,吃架构红利。文本向量离线固化意味着标签是可编程的:重算本院词表做标签扩展,研究小样本下对比学习的校准方法;用 radar_ft 开关微调 RADAR+,或者用本院数据蒸馏轻量模型,算力不够的医院也能走;organ_token_flags 反投影的可视化,是免重训解释性工作里比较稀缺的选题。
应用类,面向未来能力。报告生成模块接口已经留好,可以研究"概率加定位加测量"结构化候选喂给院内私有化 LLM 的出稿质量;叠加配准和对比管线,做随访和疗效评估;把 146 标签筛查接进体检、分诊流程,做卫生经济学和工作流研究。
报告正文要的是位置、大小、形态、强化,模型只给概率。医生省不了描述和测量,信任就建立不起来。这一步是自建影像 AI 的关键一跃,而且全程不用重训 RADAR。
organ_token_flags 记录了每个器官对应哪些图像 token,把这些 token 反投影回原图,就是器官向量的空间响应热区:每个概率都有图可依,这是免重训的解释性原料。同时 RADAR 自带全分辨率 18 类器官分割结果,器官级定位(在哪个器官、体积、最大径)直接可算;换算时按真实体素间距(affine)来,别用 5mm 重采样网格,否则体积误差会很大。
让 RADAR 做初筛,只对高概率的器官跑病灶分割模型,算力和假阳负担都小很多。可以接 nnU-Net 或者 TotalSegmentator 的生态:RADAR 本身和它们是同源的,也可以接院里已有的分割模型,比如肺结节、肝脏病灶项目。病灶的径线(最大径,近似 RECIST 语义)、体积(体素计数乘真实体素体积)、平均 CT 值,在分割掩膜上加真实间距算出来。
把概率、定位、测量组装成结构化候选,交给院内私有化 LLM 起草报告,医生审改后落报告;叠加配准和对比管线,能看前后片的变化,做随访趋势。LLM 只负责起草,测量和责任都在医生手里,这是合规允许的形态。
范式变了。以前是"一病一模、从零训练",数据、算力、标注三座山,单家医院基本走不通。现在是"开源基座加适配验证加分层补足",预训练成本被 RADAR 卸掉了,医院稀缺的是能验证、能标定、能集成、能补足的人。
组织上,这几件事都需要"临床加工程"的复合人才,团队价值从"能训模型"变成"能让模型在本院被信任"。用本院报告微调 RADAR+ 的数据飞轮,和科研发表可以同步滚动。
对商业产品的影响也直接:RADAR 顶掉的是无证的通用预读类软件采购。已注册产品的差异化在注册证、病灶定位测量、责任兜底和实施服务。医院拿到基线之后,商业报价就得对应增量价值,这是采购格局层面最直接的变化。
代码仓库(Apache 2.0):github.com/alibaba-damo-academy/damo-radar
模型权重(CC BY-NC-SA 4.0):huggingface.co/radar-generalist
Zenodo 归档:zenodo.org/records/21271172
人民网:达摩院通用医疗影像 AI 模型 DAMO RADAR 开源
ZAKER:阿里联手浙一登顶《科学》(AUC 0.913 口径)
免责声明:
智慧医疗网转载其他网站内容,出于传递更多信息而非盈利之目的,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任!
凡来源注明智慧医疗网的内容为智慧医疗网原创,转载需获授权。