医院引入了一套AI影像工具。屏幕上,它能迅速圈出可疑区域,给出风险分数,准确率也写得很漂亮。
但患者真正关心的,往往不是AUC是多少,而是三个更直接的问题:它有没有减少漏诊?有没有改变治疗?有没有让人少住院、少发生严重并发症,或者活得更久?
2026年8月19日,PLOS Digital Health发表的一项研究,把这个问题摆到了台面上。研究者梳理了1357项获得美国FDA放行或批准的AI/机器学习医疗器械记录,发现只有3项以患者中心结局作为主要评价终点。
这个数字很醒目,也很容易被误读。
这项研究说明,医疗AI的公开证据中存在明显的“临床验证缺口”:大量产品有技术性能材料,真正把死亡、重大疾病事件、再住院、生活质量或功能状态作为主要终点的公开研究却极少。
但它不能被简化成“1354项AI都没用”,也不能说明FDA完全没有监管。更准确的理解是:
> 获得监管放行,证明产品达到了相应监管路径的要求;证明它在真实医疗环境中持续改善患者结局,则需要另一层、更长期的证据。
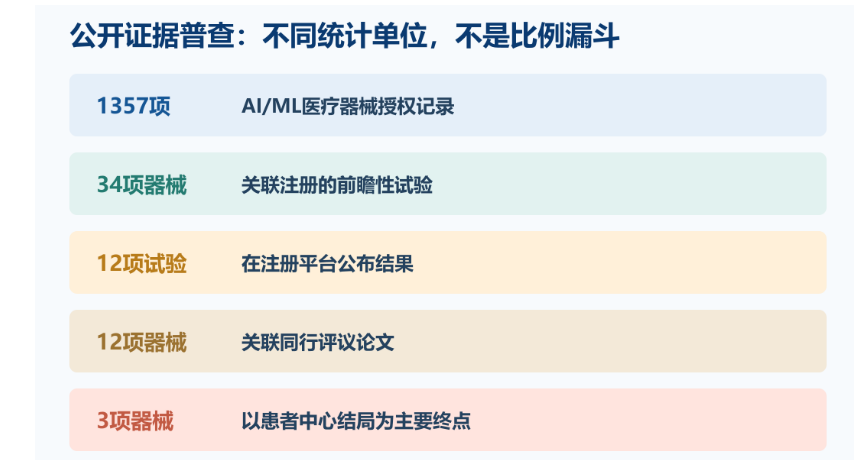
研究者汇总了FDA公开数据库及美国放射学会数据科学研究所目录中,截至2025年12月5日的1357项AI/机器学习医疗器械授权记录,再与ClinicalTrials.gov和PubMed进行关联。
证据一路往下筛:
研究还指出,在被识别出的研究中,62%采用观察性设计,并存在样本较小、人群同质、亚组分析有限,以及部分脆弱人群经常被排除等问题。
这里要特别注意研究口径。“患者中心结局”不是指AI有没有把片子看对,而是患者最后有没有获得可以感受到的健康收益,例如死亡风险、重大疾病事件、再住院、生活质量、功能状态或症状负担。
敏感度、特异度、准确率、AUC,以及单纯节省医生时间,当然都重要,但在这项研究里属于技术或流程指标,不等于患者结局。
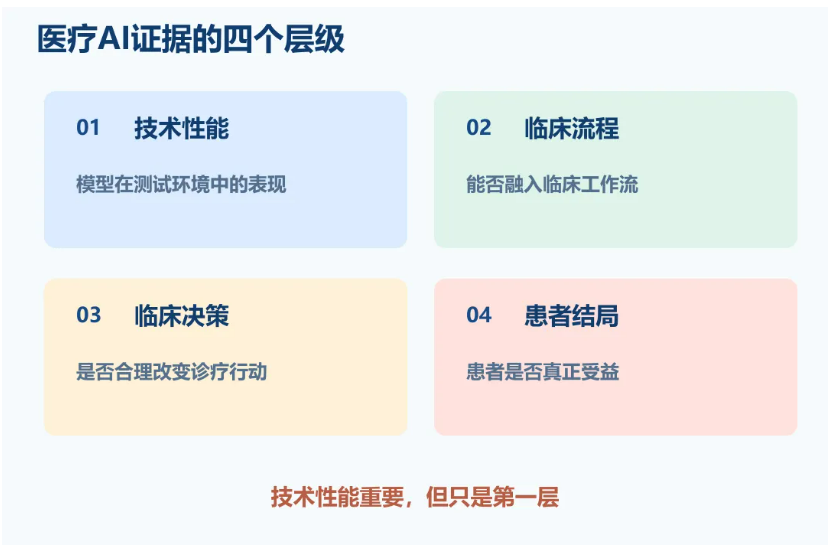
AI能不能在既定数据集上正确识别病灶?敏感度、特异度和AUC如何?
这是最常见、也最容易标准化的一层。它回答的是:模型在测试环境里会不会做题。
AI进入医院后,是否真的融入医生工作?它有没有减少重复劳动、缩短报告时间,或者让医生更快发现需要优先处理的病例?
这一层比实验室指标更接近现实,但流程变快仍不自动等于患者更健康。
医生看到AI结果后,诊断、检查或治疗是否发生合理改变?误报会不会带来不必要的检查?漏报有没有被医生及时发现?
到这一层,AI已经开始影响真实医疗行为。
患者是否因此少发生严重事件、减少再住院、改善症状、生活质量或功能状态?收益能否持续?不同年龄、性别、族群和医院环境中的效果是否一致?
这才是研究强调的最终一层,也是最难、最贵、最需要时间的一层。
假设一套AI在一批精选影像中表现很好,进入真实医院后仍可能遇到新的问题:
第一,真实患者更复杂。老人、儿童、孕产妇、少见病患者和多病共存人群,可能在开发数据中比例不足。
第二,工作流程会改变效果。AI提示放在哪里、谁负责查看、医生是否容易形成自动化依赖,都会影响结果。
第三,误报和漏报的代价不同。一个看起来很高的总体准确率,可能掩盖某个重要亚组表现较差。
第四,工具被发现异常后,医院能否及时停用、更新或追溯,也是临床安全的一部分。
所以,准确率不是没价值,而是它只回答了一部分问题。
不能这样下结论。
FDA对医疗器械有不同监管路径。很多器械通过510(k)路径,需要证明与已合法上市的同类器械具有“实质等同”;创新程度和风险不同的产品,也可能走De Novo或上市前批准等其他路径。
监管放行的任务,是依据对应路径评价安全性、有效性或实质等同等要求。它不意味着每一种辅助工具在上市前都必须完成以死亡率或再住院为终点的大型随机试验。
另外,这项PLOS研究主要依赖公开数据库进行关联。没有找到公开研究,可能意味着没有注册、没有发表、结果未公开,或者研究与具体器械没有被准确关联。FDA还存在生产商报告、上市后监测和不良事件数据库等机制。
因此,最稳妥的表述是:
> 研究发现公开可追踪的患者结局证据非常有限,而不是证明其余产品全部没有临床价值。
第一,医院采购AI时,不能只看算法指标和演示效果,还要看适用人群、真实环境测试、工作流风险和上市后监测。
第二,开发者应更早考虑临床研究,而不是产品放行后才问“患者是否真的受益”。
第三,研究结果需要公开。即使试验结果不理想,公开也能避免其他医院重复踩坑。
第四,患者结局不是唯一有价值的指标,但应成为证据阶梯中的最终方向。一个分诊工具可能先证明节省时间,一个影像工具可能先证明减少漏诊;随着使用扩大,仍应继续追踪患者最终结果。
当你在医院、体检机构或健康软件中遇到“AI辅助”时,不必一看到AI就拒绝,也不要把它当作独立医生。可以问:
如果AI给出的是影像提示、风险评分或病历摘要,谁负责审核并向你解释?
用于排序和提醒的工具,与直接决定检查、诊断或治疗的工具,风险层级不同。
研究对象是否与你相似?只在大型医学中心测试过的工具,到了基层医院可能面临不同流程和数据。
最终由谁决策?错误如何记录、反馈和追踪?这些比一句“准确率很高”更重要。
普通人不需要自己读懂所有临床试验,但可以确认一个底线:重要医疗决定不能只剩下一条未经解释的算法结论。
这项研究的价值,不是给医疗AI判死刑,而是把证据标准往前推了一步。
过去,行业最爱展示的是“模型比医生快多少”“准确率提高多少”。这些指标让人兴奋,也更容易写进宣传材料。可医疗最终服务的是患者,不是排行榜。
真正成熟的医疗AI,不只是能在测试集上做对题,还要在真实医院里经得住不同人群、不同设备和不同流程的检验;出错时能被发现,更新后能被追踪,长期使用后能回答患者到底有没有受益。
> 医疗AI通过了技术考试,不等于已经交出了患者获益的成绩单。
☑ PLOS Digital Health同行评议研究覆盖1357项FDA AI/ML医疗器械授权记录
☑ 研究方法、定义、补充数据和检索口径公开
☑ FDA官方资料可用于区分不同监管路径及510(k)含义
☑ npj Digital Medicine与JAMA Network Open研究提示报告和泛化性缺口
☒ 公开数据库关联可能漏掉未注册、未公开或无法匹配的研究
☒ “患者结局证据少”不能直接推导为产品无效或不安全
☒ 研究以美国监管和公开数据库为主,不能直接套用于中国所有医疗AI
📌 下次看到“医疗AI准确率超过95%”,先别急着把它理解成“患者一定受益”。关注「树叶健康」,回复关键词「验证」,领取《医疗AI证据四级判断卡》,用四层证据快速看懂一个AI工具到底证明到了哪一步。
免责声明:
智慧医疗网转载其他网站内容,出于传递更多信息而非盈利之目的,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任!
凡来源注明智慧医疗网的内容为智慧医疗网原创,转载需获授权。