原始文献:Heydari AA, Gu K, Srinivas V, et al. The anatomy of a personal health agent. Nature. 2026;659:197–207. DOI:10.1038/s41586-026-11161-8。
研究团队:Google Research、Google DeepMind、哥伦比亚大学等。
研究性质:多智能体系统开发与多维基准评测,非改善患者临床结局的随机试验。
未来个人健康AI的竞争,也许不再只是“哪个大模型更聪明”,而是“谁能把计算、医学判断与行为干预组织成可靠的协同流程”。
假如一个人问:“最近睡得不好,是不是运动不足?我应该怎样调整?”这个问题看起来简单,实际上同时需要读取可穿戴设备的纵向数据、执行统计计算、理解医学证据,再结合个人习惯制定可执行的目标。
通用大语言模型可以给出流畅建议,却未必能准确完成时间序列统计,也未必能区分“数据显示相关”与“行为导致改善”。研究团队认为,真正的个人健康支持需要不同能力协作。
为避免只凭开发者想象设计产品,研究者分析了1,370条真实消费者健康问题、收集555份用户调查,并组织14名用户体验与工程专家开展工作坊,最终将需求归为健康知识、个人数据解读、健康建议和症状咨询四大旅程。官方补充材料进一步拆分为26种问题子类型,并为其制定智能体分工规则。
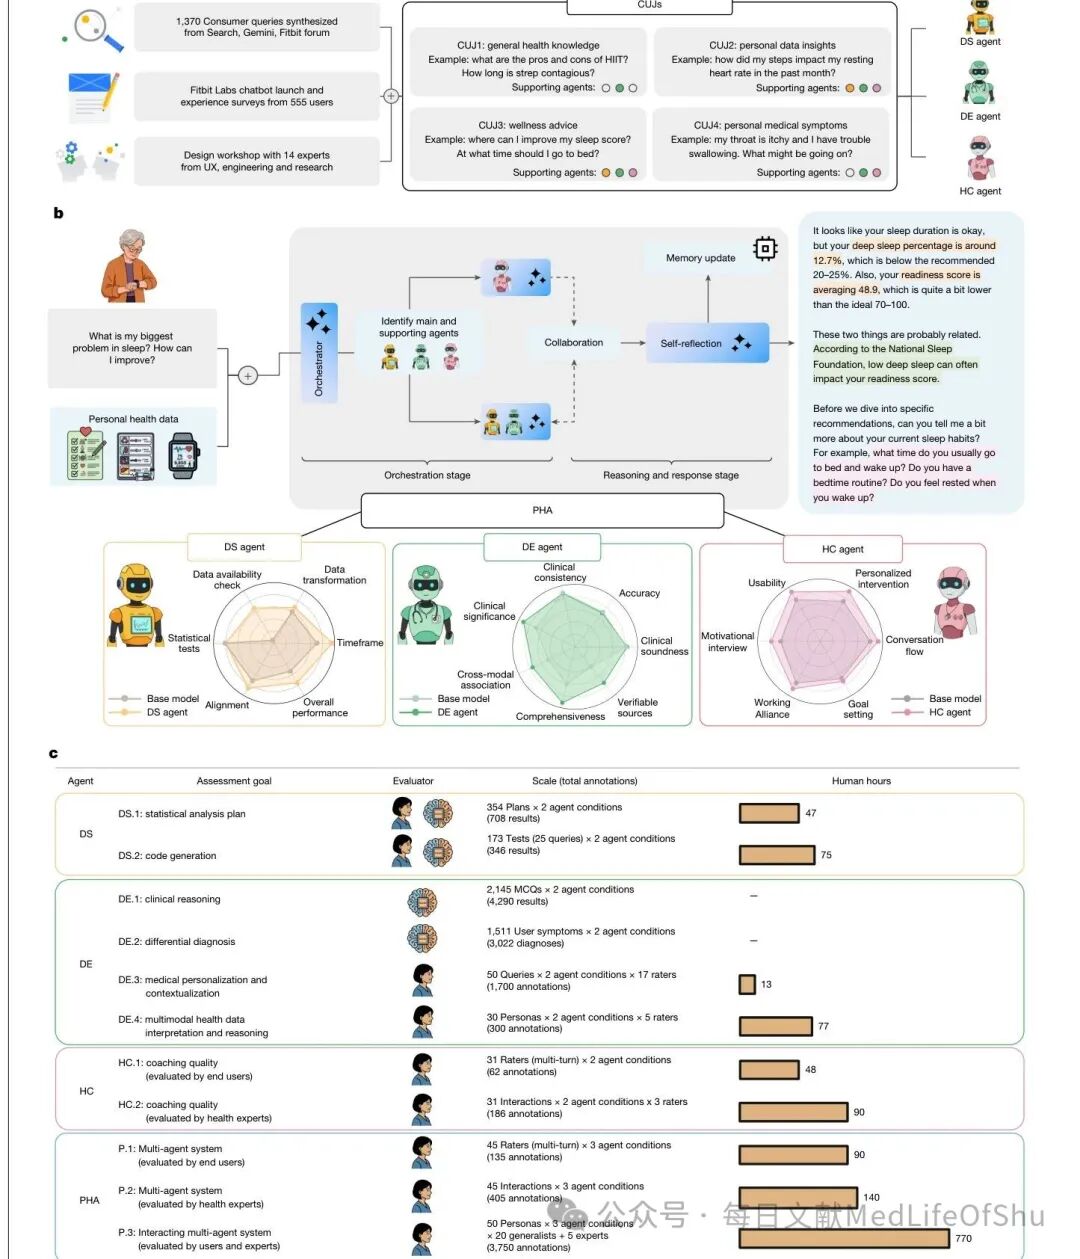
这项研究的核心并不是训练新的基础大模型。作者采用Gemini 2系列作为底层模型,重点开发由一个任务编排器(orchestrator)调度的Personal Health Agent(PHA)。
① 数据科学智能体(DS Agent):将“我最近是不是睡得更好”转为有明确时间窗口、缺失数据检查和统计检验的分析计划,再编写并运行Python代码。
② 健康领域专家智能体(DE Agent):整合可穿戴指标、检查结果和外部医学知识,通过检索、核查、推理生成个性化解释。
③ 健康教练智能体(HC Agent):结合动机性访谈、SMART目标和持续对话,帮助用户把建议落实为行为。
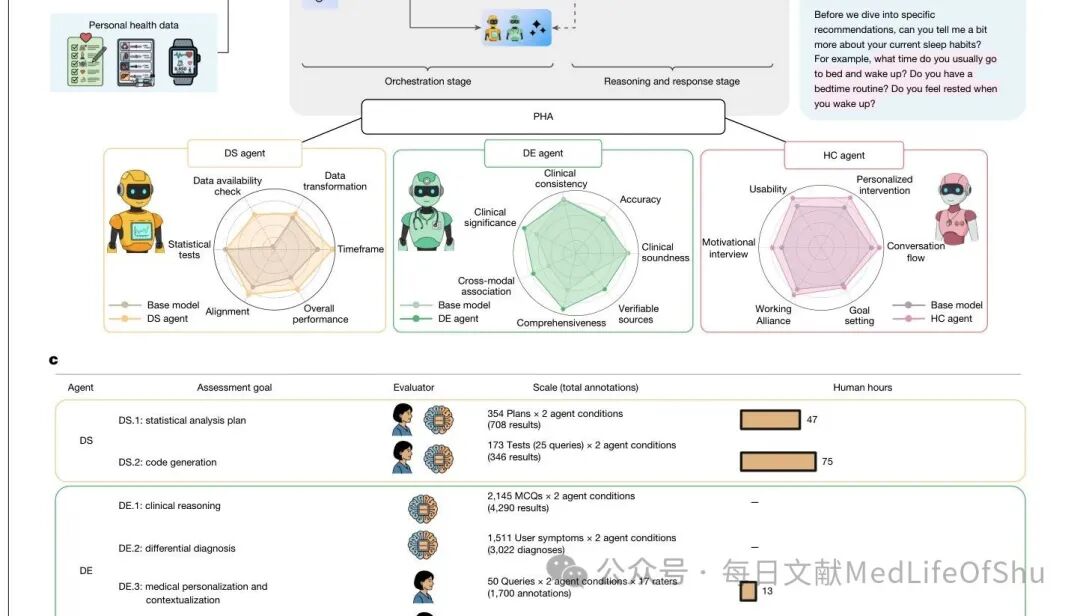
当一个问题横跨多个任务时,系统先判断主责Agent及辅助Agent,再分别拆解问题、协作输出、反思并更新对话记忆;并不是每次都让三个模型同时回答。
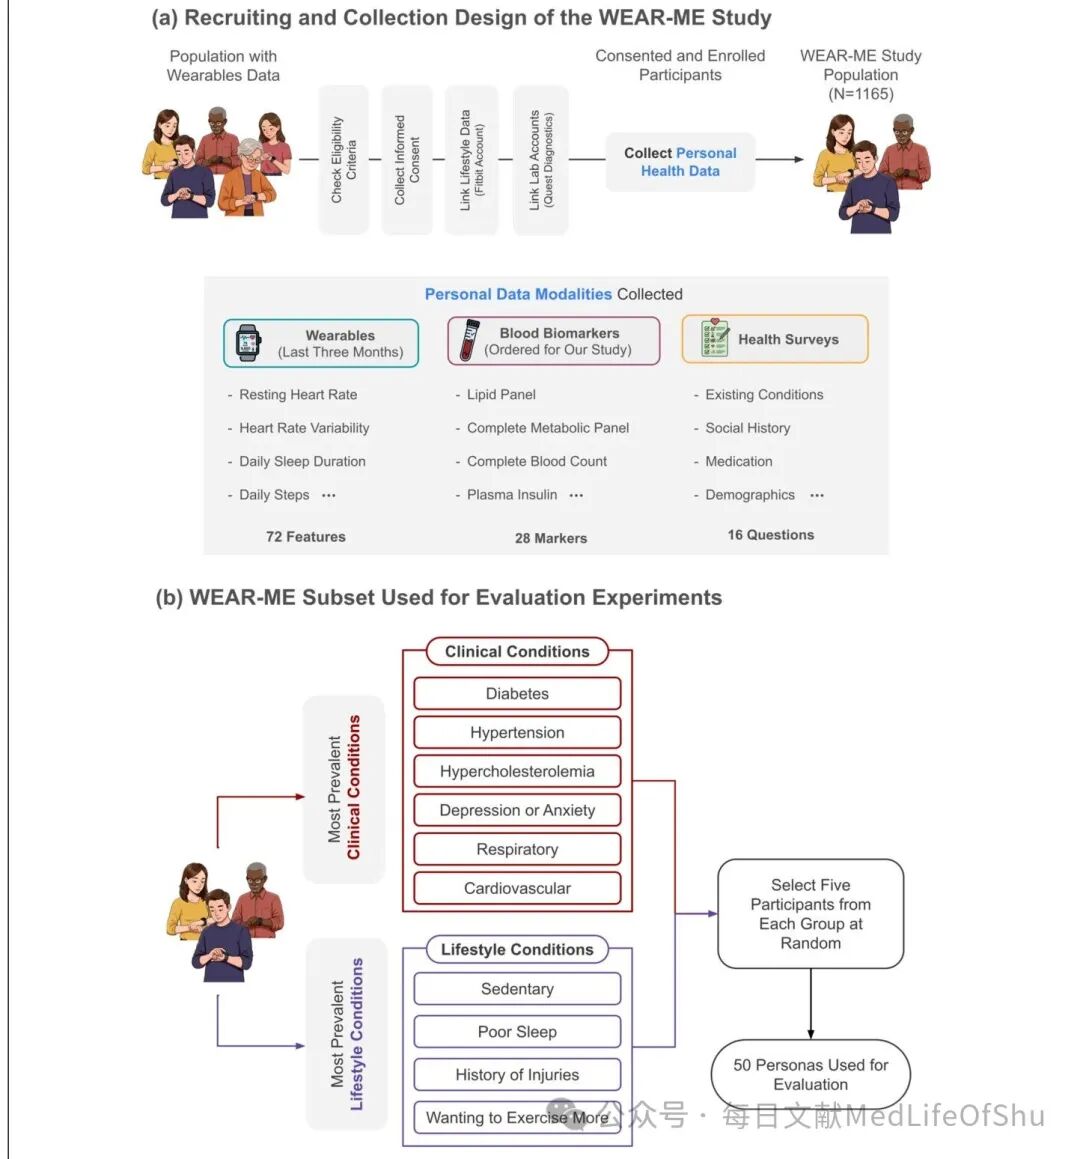
评测使用的真实健康数据基础为WEAR-ME研究(n=1,165),数据包括Fitbit可穿戴记录、血液检测结果和问卷;部分交互研究使用从中构建的50个代表性健康档案。特别需要说明,论文在这次实验中可用的“医疗记录”主要是血液检验报告,并非完整医院电子病历。
系统及组件累计接受11项基准任务的检验,涉及超过7,000个人工标注及1,350小时用户与健康专家工作量。这些数字反映评测投入,并非7,000名患者接受了临床干预。
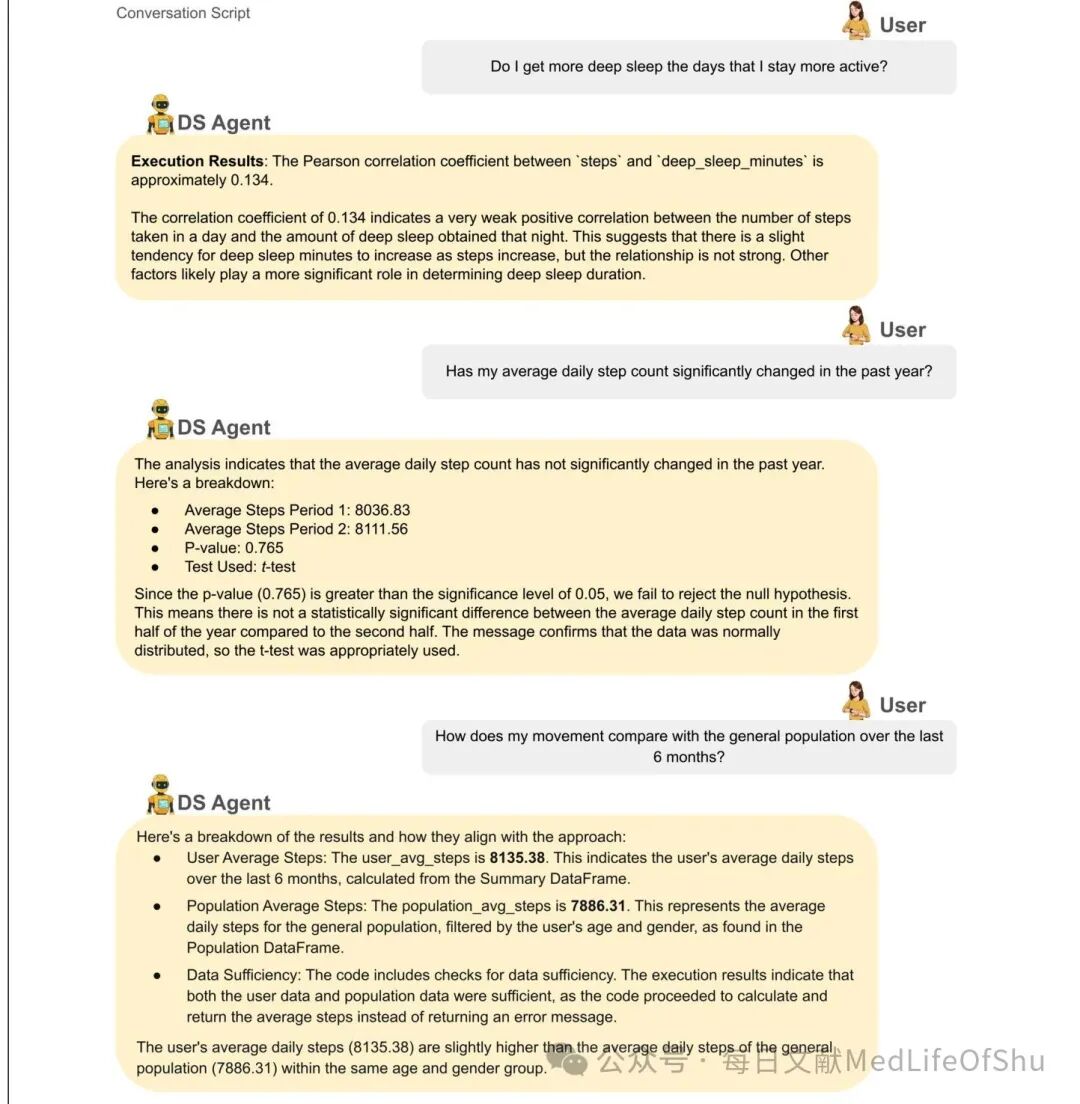
数据科学Agent最关键的设计是 “先生成分析计划,再运行代码”。例如用户询问“多走路会让我获得更多深睡眠吗”,系统需要先确定活跃日阈值、时间范围、缺失值处理和适当统计方法,而非仅依靠自然语言作答。
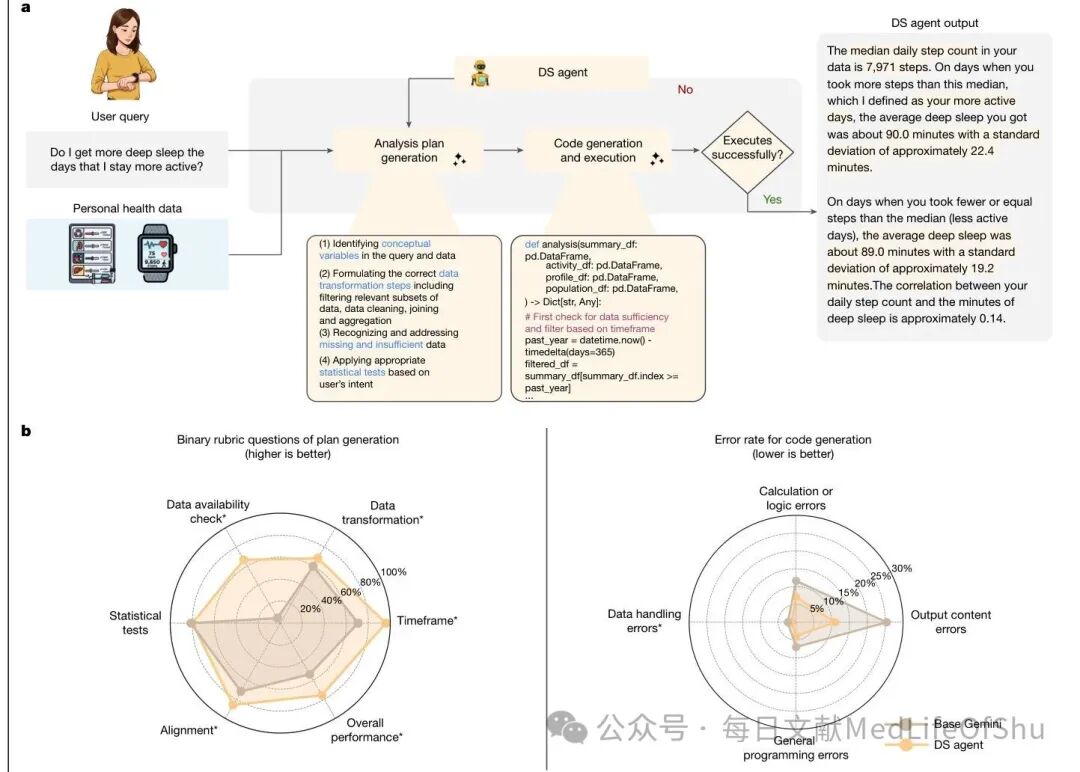
在分析计划质量评测中,DS Agent平均得分为75.6%,基础Gemini为53.7%(P<0.001)。在173项单元测试中,首次代码通过率达到75.5%,高于基础模型的58.4%,经过最多五轮自我修正后为79.0%。
提升主要来自数据可用性、时间窗口、变换过程和数据处理错误的减少,而非每一类统计能力都显著改善。补充材料还给出了跨模型消融,提示这种“规划—执行—纠错”方法并不完全依赖某一个基础模型。
医疗专家Agent借助医学文献检索、人口数据查询、个人指标解释等工具,按照“推理—调查—审查”的循环组织回答。与单纯生成文字相比,它更强调可核查来源与用户自身数据之间的联系。
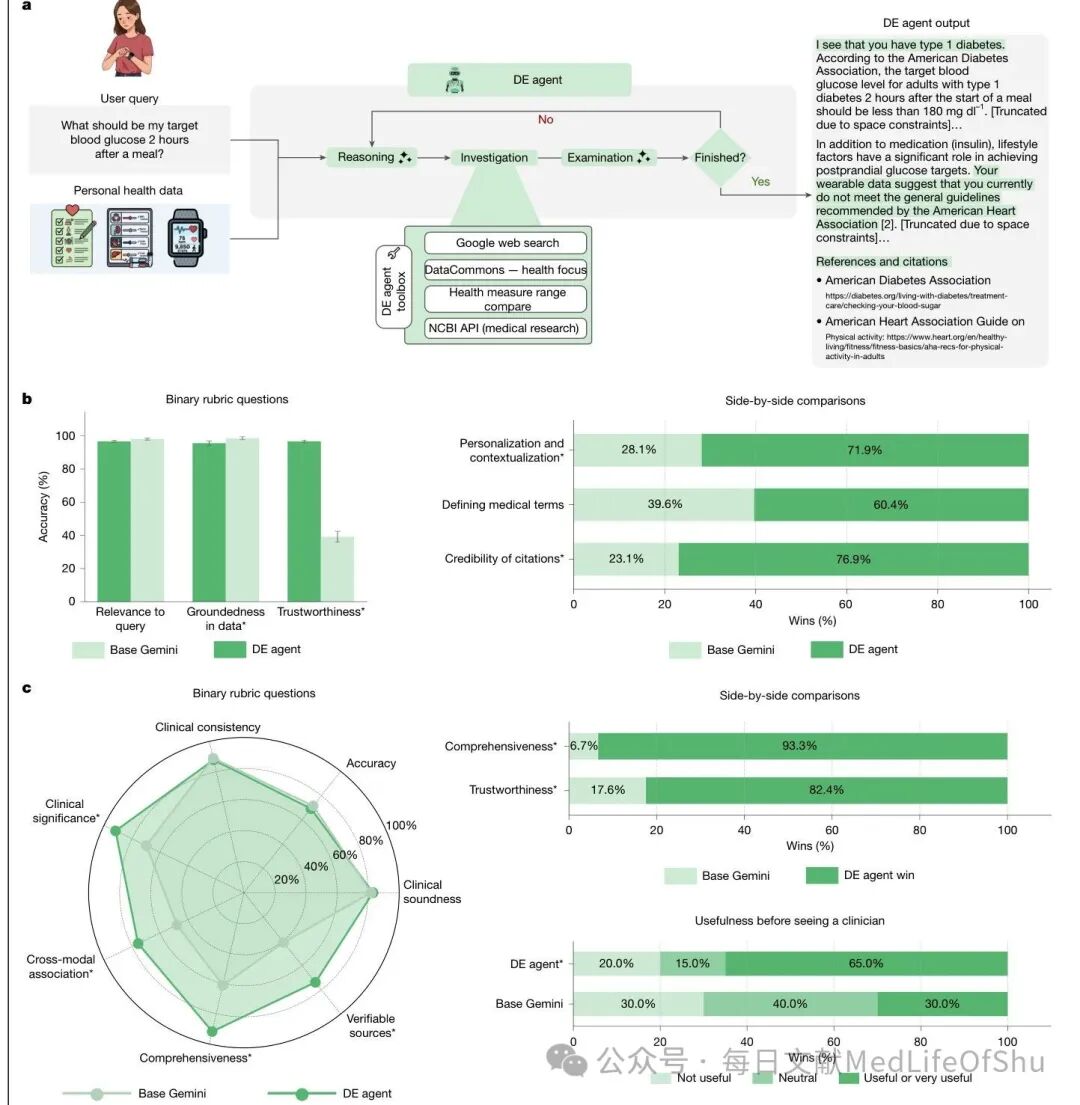
在2,000余道医疗与健康知识选择题上,DE Agent的总体正确率为83.6%,略高于基础模型的81.8%。在自报症状的鉴别诊断测试中,约2,000个原始案例经质量筛选后约1,511例用于主要比较;其Top-1正确率为46.1%,对照为41.4%,Top-5则为75.6%对71.4%。
也就是说,智能体框架的确改善了鉴别诊断排序,但首位诊断仍有超过一半的案例未命中参考诊断。这项能力不能被包装成已经达到独立诊断水平。
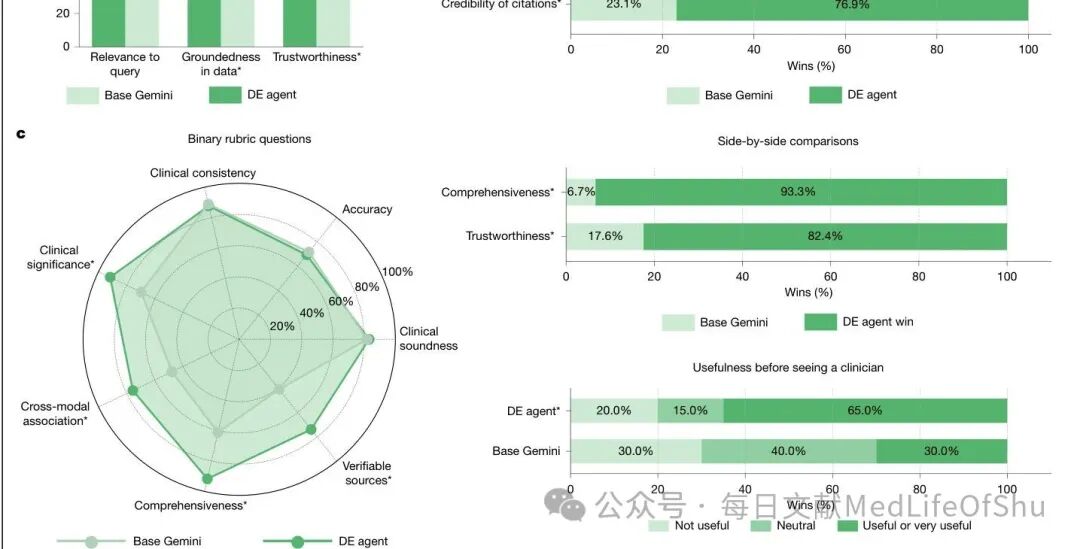
在30份多模态个人健康摘要的专家评审中,65%的DE Agent摘要被评价为“有用或非常有用”,基础模型为30%。但补充材料的分项数据还显示:临床事实准确性指标约为72.7%对75.0%,差异不显著。“回答显得可信”不等于每条医学事实都更正确。
健康教练Agent并不只罗列运动或睡眠建议,而是围绕目标澄清、主动倾听、障碍识别、用户赋能、具体行动和反馈迭代组织多轮对话。研究分别由31名真实用户和3位健康教练专家在盲法条件下评价其对话。
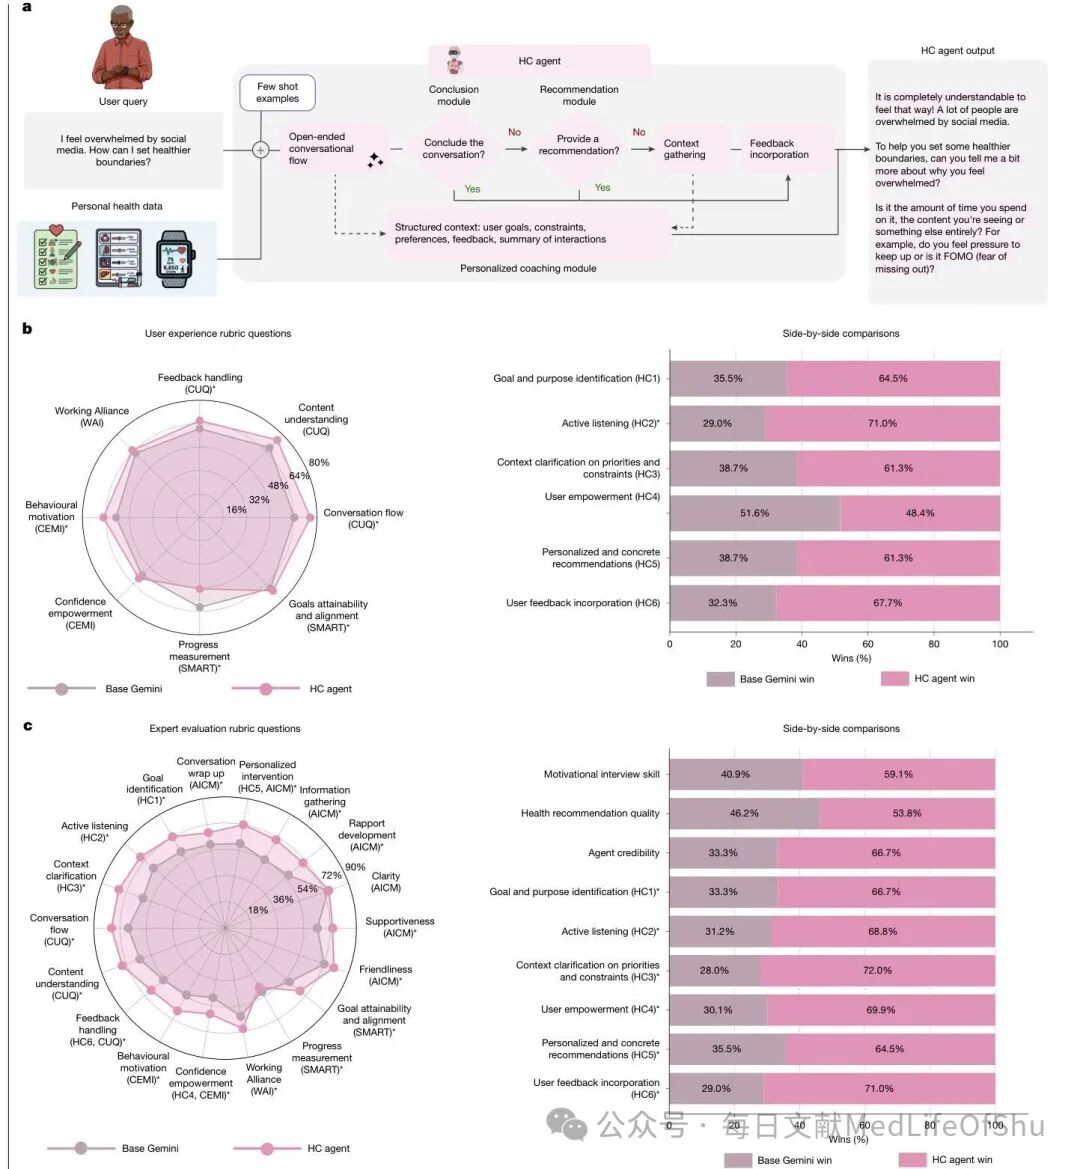
用户在多个教练维度更偏好HC Agent,部分指标的胜出比例约为61%–71%;专家认为它在目标澄清、积极倾听与个性化干预等维度更好。不过,基线模型在“进度测量”方面并非始终落后,提示复杂架构并不是所有环节都必然占优。
研究进一步把完整PHA与两类对照比较:一个能力较强的单智能体系统PHIA,以及三个专业Agent各自独立回答、缺乏动态协作的并行多智能体系统。
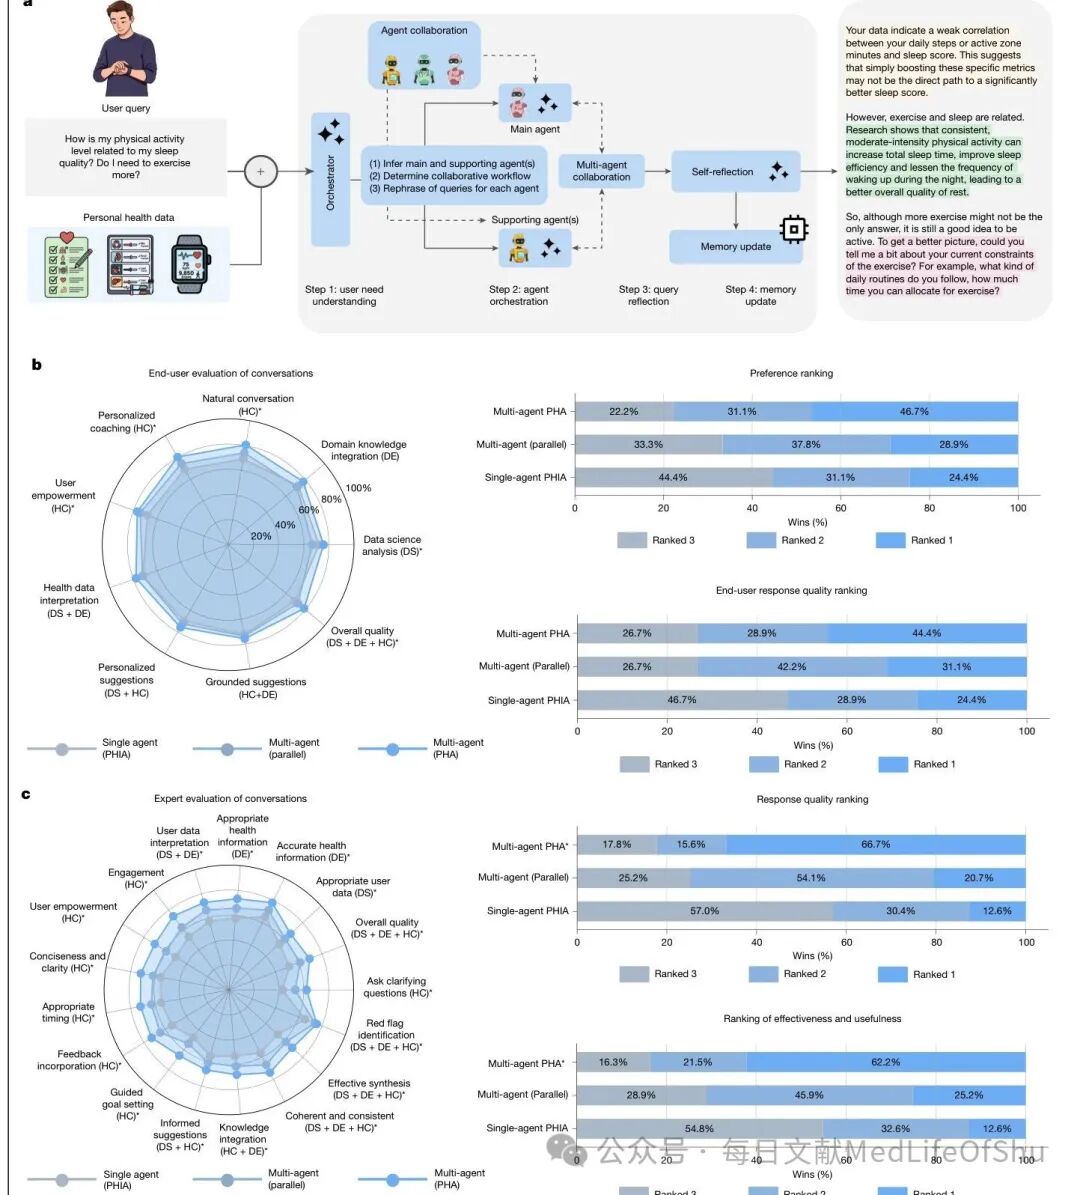
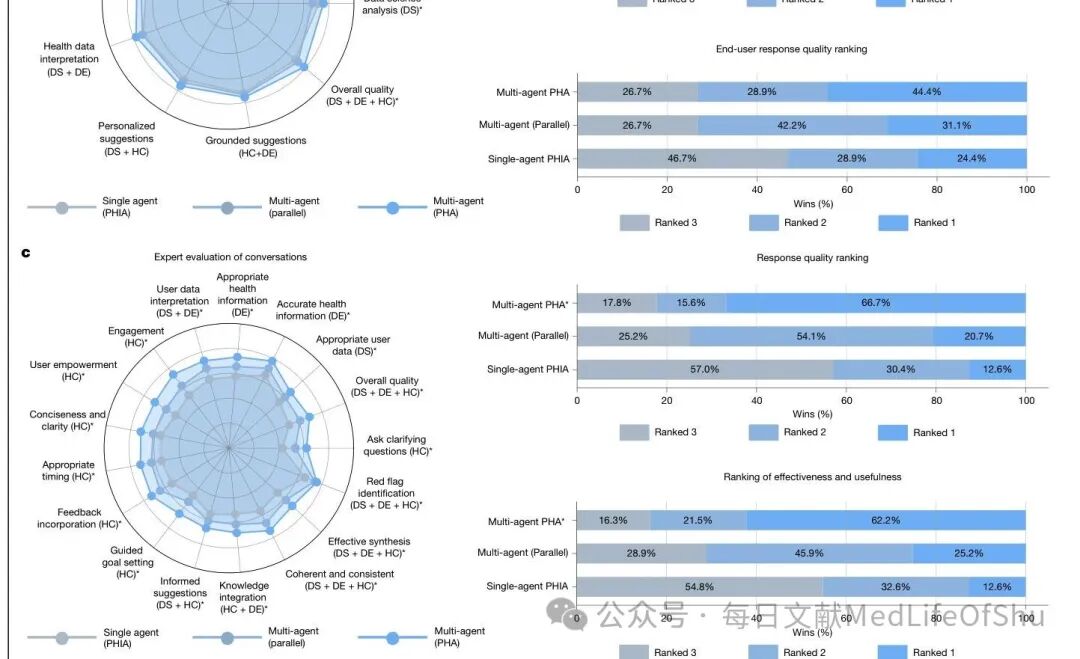
在45名用户的真实多轮交互中,完整PHA获得“总体最喜欢”的第一名比例为46.7%,并行多智能体为28.9%,单智能体为24.4%;而3名专家在整体质量评价中将PHA排第一的比例为66.7%。专家给出的平均整体质量分数为PHA 72.8%,并行方案64.3%,单智能体54.4%。
需要保留统计学边界:官方补充表S38显示,45人样本中的总体偏好第一名比例整体检验未达到传统显著性阈值(P=0.101),因此不能简单宣传“PHA在所有用户总体排序上显著胜出”;论文中若干具体交互体验指标则呈显著改善。
此外,多智能体不是免费的。作者报告的补充成本分析中,PHA每轮平均约205秒,虽低于并行多智能体约244秒,却远慢于单智能体约36秒;平均模型调用分别为6.5、7.0和3.0次。这意味着真实产品还必须在质量、延迟、成本和用户体验之间权衡。
论文将PHA明确界定为面向消费者健康与生活方式的研究原型,而不是临床诊断或分诊系统。现阶段研究主要证明特定任务和交互体验改善,尚未通过前瞻性临床试验证明其能减少住院、心血管事件或其他患者结局。
安全性也绝不能被高分掩盖。专家对DE Agent健康摘要的潜在伤害评估发现,83%被认为无或仅有极小潜在伤害,15%为轻度,2%为中度至重度潜在伤害。在规模化健康咨询场景,少量高风险错误也值得严肃对待。
其他局限包括:原型医疗记录仅涉及血液检查,未覆盖完整EHR;用户和专家交互样本规模有限;合成对话与真实使用仍有差别;数据、设备和人群可能影响泛化;记忆模块与网上检索引入隐私、证据质量和跨轮安全问题。研究者建议增加高风险症状识别、人工转介、持续验证及公平性评估。
这项工作的证据支持“多Agent可改善部分健康信息处理与互动质量”,但不支持“AI个人医生已经可以替代临床专业人员”。
以1,370条问题、555份调查与26种用户需求子类型搭建研发框架,增强了场景的真实感;这是医疗AI应用研究值得学习的“需求先行”。
分工清晰后,每个模块都能用对应的能力指标评价,而不只是给整体聊天质量一个模糊分数。
代码单元测试、事实核查、参考文献可信度、临床一致性,与纯LLM问答正确率相比,更接近医疗工作流的真实要求。
同底座的单智能体、无编排并行多智能体与有编排协作系统形成结构性对照,有助于判断真正的增益是否来自架构,而非仅仅增加计算资源。
有吸引力的回答可能缺少医学安全性;研究将用户、数据科学专家、健康教练和临床专家评价分开,并展示错误与伤害分布,有助于避免“用户喜欢=医疗可靠”的推断。
下一步更有价值的终点是有无减少错误建议、延迟就医、人工工作量以及是否改善长期健康行为或临床结局。对于医学AI研究者,这可能比继续刷新基础模型榜单更重要。
原始文献:Heydari AA, et al. The anatomy of a personal health agent. Nature. 2026;659:197–207. https://doi.org/10.1038/s41586-026-11161-8
补充材料:Supplementary Information(Sections A–G;Supplementary Tables 1–45;Supplementary Figures 1–7)。官方Supplementary PDF。
研究图表均来自原文,部分图片为便于手机阅读的原图局部裁切;未重新绘制研究数据图表。
免责声明:
智慧医疗网转载其他网站内容,出于传递更多信息而非盈利之目的,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任!
凡来源注明智慧医疗网的内容为智慧医疗网原创,转载需获授权。